开启 3 天免费试用
注册即可免费体验全部高级功能。
*仅限新用户;每位用户只能获得一次试用。
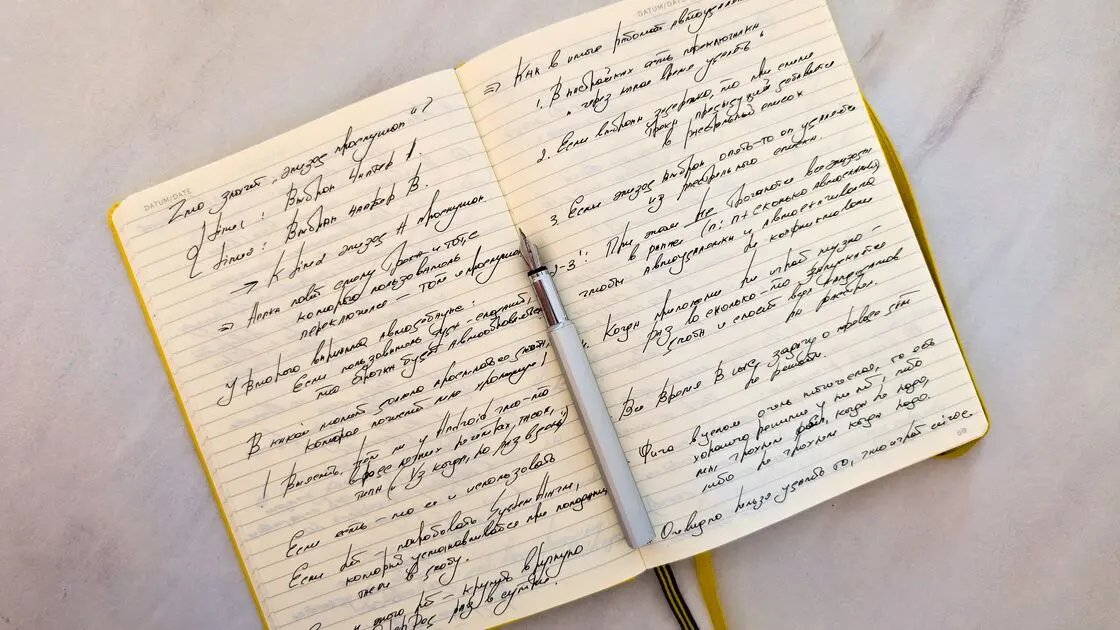

要用 AI 将手写笔记转成可编辑文本,先保留原始页面,拍清楚,再逐页运行手写 OCR,并对照图像复核每个不确定的字符。把忠实转录与任何编辑版本分开,免得语法润色变成对“作者在纸上写了什么”的错误陈述。
关键要点:
- 清晰的原图能改善 OCR,但不能让结果变得权威。
- 润色之前,先保留页序、换行、复选框、边注和不确定之处。
- 人名、数字、日期、单位和短标签要逐字符核对。
- 原始图像、原始 OCR、复核后的转录稿和编辑日志分层导出。
本流程沿用 安全使用 AI 的核验闭环的原则:来源始终是权威,模型只产出供人检查的候选结果。
先确认你有权处理这些笔记。个人笔记本、学生作业、研究记录、会议记录、客户笔记,以及医疗或法律材料,可能各有不同的保密、保留和同意义务。不要把含有密码、访问密钥、身份证件、私人客户数据或其他不必要敏感信息的页面上传到未经批准的服务。
编辑任何内容之前,先冻结原件。给每页一个稳定的标识,例如 Notebook-03 / Page-017,记录拍摄日期,并保持原始文件不变。如果页面有正反两面,两面都要明确编号。一整个文件夹按相机时间命名的匿名照片,很容易被意外打乱顺序。
手写 OCR 是文档识别任务,而不是创意写作。Google Cloud Vision 的文档说明,DOCUMENT_TEXT_DETECTION 是针对密集文本和文档(包括手写)优化的 OCR 模式,其返回结果可保留页、块、段落、词和符号结构。[1] Microsoft Document Intelligence Read v4.0 可以从扫描图像和文档中提取印刷及手写文字,并返回词、行、位置和置信度。[2] 这两种能力都不能免去对照原件核对输出的必要。
处理之前先用一张简单的登记表:
| 页面 ID | 原始文件 | 正反面 | 语言 | 书写者 | 敏感级别 | 拍摄质量 | 复核者 |
|---|---|---|---|---|---|---|---|
| N03-P017 | IMG_4812.jpg | 正面 | 英文 | 已知 | 内部 | 良好 | OP |
| N03-P018 | IMG_4813.jpg | 背面 | 英文 | 已知 | 内部 | 边缘有阴影 | OP |
如果不知道书写者、语言或页序,就记为 unknown。明确的“未知”,比日后嵌进文本里的看似合理的猜测更安全。
拍摄质量决定了识别器能看到多少证据。使用均匀光线,相机与纸面平行,拍全四个角,对焦在墨迹上而不是下面的桌面。避免手指遮住文字、强阴影、反光、过度滤镜,以及会裁掉边注的透视校正。
美国国家档案和记录管理局的数字化指南强调,要通过受控的拍摄、质量复核和保存考量来制作生产母版文件。[3] 你的笔记项目也许小得多,但这个区分同样有用:保留一份高质量母版,工作副本都从母版派生。
每一页:
不要把一张又小又糊的照片放大后就称为“修复”。放大可能让图像看起来更平滑,底下的字符却依然模糊。原图不足时,把该页标为需要重拍。
旋转、无损的方向校正,以及只裁掉页面外区域的保守裁剪,可以让图像更易处理。修改笔画、擦掉划线、把对比度调到淡痕迹消失,或补全缺角,都会改变证据。保留母版,并记录每一步派生操作。
逐页或按顺序小批量处理。大批混杂的页面,更难发现缺页、正反面颠倒或语言变化。工具提供模式选择时,选文档 OCR 或手写识别;通用的图像描述模型可能会转述页面,而不是转录。
使用受来源约束的指令:
忠实转录手写内容。在可见的情况下,保留页面 ID、标题、换行、列表符号、复选框、删除内容、箭头和边注。无法辨认的字符写
[unclear],并附上前后文字。不要纠正拼写、补全残句、推断人名,也不要把笔记改写成报告。
要求按页输出并带行标识。版面重要时,要求标出区域,例如 top-left、main body 和 right margin。输出应区分已勾选和未勾选的复选框,以及被划掉的短语和确认的短语。
Microsoft 当前的 Document Intelligence Read 模型会返回识别出的词和行,并附边界多边形和置信度。[2] 位置信息很有用,能让复核人回到确切的区域。置信度可以帮助排定复核优先级,但高分并不能证明一个简短的人名或数字是正确的。
| 页码或区域 | 原始 OCR | 编辑文本 | 置信度 | 修改理由 | 复核者 |
|---|---|---|---|---|---|
| N03-P017 第 4 行 | send to Marla 8/7 | send to Maria 8/7 | 低 | 已对照手写核对人名 | OP |
| N03-P017 边注 | [unclear] 15 | [unclear] 15 | 未解决 | 首字被遮挡 | 待定 |
| N03-P018 方框 2 | [x] call vendor | [x] call vendor | 高 | 已确认复选框和文字 | OP |
这张表形成了一条编辑记录,也能防止复核人在不记录依据的情况下“修正”句子——改动究竟来自页面、外部知识还是文风偏好。
分两遍复核。第一遍逐页检查转录是否忠实;第二遍检查合并后的文档是否连贯,有无缺页、重复文字或不一致的写法。
短字符串几乎没有上下文,一个字符就可能改变含义。放大原图逐一核对:
逐个读数字,不要因为格式眼熟就接受。1、7、9、0 和 6 可能难以区分;小数分隔符和日期顺序取决于地区习惯。来源没有确定格式时,不要把 08/09 悄悄规范成某个具体日期。
使用一致的标记,例如 [unclear]、[illegible: 2–3 chars] 或 [possible: Chen/Chin],并附上页码和区域。绝不要让模型挑一个最合理的词,然后删掉不确定标记。
NIST 的生成式 AI 风险概况把虚构、隐私、信息完整性和人工监督列为风险领域。[4] 在本流程中,不确定标记和人工复核队列就是应对这些风险的具体控制。
把页面登记表与输出对照。确认每页恰好出现一次,正反面顺序正确,标题仍与其内容相连,续写标记没有被误认为新章节。留意因照片重叠造成的首行或末行重复。
如果书写者用了箭头或空间分组,描述其关系时不要过度解读:写“从条目 A 指向条目 B 的箭头”,而不是“条目 A 导致条目 B”。空间含义对白板尤其重要,白板需要另一套理解版面的流程。
把复核后的转录稿设为只读,再另建一份编辑稿。编辑稿只能在明确规则下规范空格、展开缩写、修正拼写或重组标题,不得覆盖忠实层。
使用三层结构:
标注所有添加。如果为便于浏览加了标题,写 [editor heading]。如果借助其他来源的背景确认了某个人名,记录外部证据,而不是假装手写本来就清楚。如果要把笔记变成正式交付物,在转录获批后使用单独的笔记转报告流程。
选择开放、可编辑的格式,例如纯文本、Markdown、用于结构化字段的 CSV,或文字处理文档。写明项目名称、页码范围、OCR 工具和模式、处理日期、复核人、未解决数量和编辑政策。
原始 OCR 只有在有助于审计改动时才作为中间产物保留,不能被误当作复核后的转录稿。所有副本——包括云端上传和临时导出——都要遵守组织的保留和访问规定。
模型可能把残句补成完整句子。先要求忠实转录,再在副本中按可见规则编辑。
置信度是排序复核的信号,不是事实依据。高置信度的人名、日期和数字仍需直接复核。
纯文本可能抹掉状态。明确表示未勾选框、已勾选框、删除、插入和边注。
原图能解决争议,也能支持日后改进。保留稳定的母版,绝不要用增强后的派生图替换它们。
缺页或重复页可能藏在一份润色过的文档里。合并文字之前,先核对页面登记表。
它能给出有用的初稿,但准确度因字迹、语言、图像质量、版面和上下文而异。把每份输出都当作候选转录,对照页面核对有后果的字段。
两者都可以。扫描仪的几何和光线更一致;手机则很方便,前提是与纸面平行、对焦清晰、光线均匀,并拍全所有边缘。
保留不确定标记,并附页码和区域。重拍该页、比对附近的字迹样本,或请获授权的复核人判断;不要用最合理的词填补空白。
忠实层里不可以。先保留原本写下的内容,再另建一份编辑稿,并记录其拼写和语法规则。
明确表示其可见状态和位置。描述关系时保持保守,不要把旁边的笔记或箭头变成已批准的行动或因果结论。
不能。用 OCR 置信度排定复核顺序,但即使报告的置信度很高,也要检查人名、编码、日期、数字和单位。
不可以。先确认服务、账户、保留、访问权限和组织批准,并删除不必要的敏感信息。有些材料应留在获批的本地或企业环境中。
按保留政策保存未改动的原始图像、复核后的转录稿、编辑稿、页面登记表、修改日志和未解决事项清单。
来源:
Sources checked 2026 年 8 月 30 日。
延伸阅读:
注册即可免费体验全部高级功能。
*仅限新用户;每位用户只能获得一次试用。