開啟 3 天免費試用
註冊即可免費體驗全部高級功能。
*只限新用戶;每位用戶只可獲得一次試用。

要安全地用 AI 為程式碼除錯,先由一個可重現的故障入手,給模型證據而非理論,每次只檢驗一個假設。目標不是令錯誤訊息消失,而是找出原因、證明修正有效,並保留一個在 bug 重現時會失敗的回歸測試。
一般的 AI 實用工作流程仍然適用,但除錯需要更嚴格的證據循環。一個看似合理的解釋,在受控觀察把它與其他可能區分之前,都只是假設。
關鍵要點
- 要求修正前,先凍結一個可重現的故障。
- 把觀察、假設、實驗和結論分開。
- 分享前為日誌脫敏,並把故障輸入減到最少。
- 每次實驗只改變一個相關變數。
- 修正後,把故障個案保留為回歸測試。
把 AI 當作調查助手:讓它整理證據、提出排序後的可能原因、解釋不熟悉的控制流程,並建議下一項能區分原因的檢查。執行和驗收仍由人掌控。GitHub 提醒,生成的回應和程式碼可能不準確或不安全,因此覆核和驗證的責任仍在用戶身上。[1]
這個方法適用於確定性故障、意外輸出、範圍明確的效能倒退,或已記錄時序證據的不穩定測試。如果唯一的回報是「production 感覺很慢」、無法確定執行環境,或你無權查看受影響的資料,它就不太管用。
開始對話前,先建立四個欄目:
| 欄目 | 含義 | 例子 |
|---|---|---|
| 觀察 | 直接量度或重現的事實 | 輸入 a,,b 時測試失敗,報 expected 2, got 3 |
| 假設 | 可能的解釋 | 空欄位被當成一個值計算 |
| 實驗 | 能區分原因的檢查 | 在過濾前輸出解析出的 token |
| 結論 | 實驗真正支持的判斷 | 空 token 進入了計數分支 |
不要因為模型語氣肯定,就把一句話由「假設」移到「結論」。只有實驗或程式碼追蹤支持它時,才可移過去。
記錄確切的指令、輸入、環境和輸出。操作屬確定性時,就執行兩次。如果故障是間歇性的,就記錄時序、隨機種子、執行次序、資源壓力和嘗試次數,而不是假裝它很穩定。
在不改變行為的前提下縮小個案。移除無關的記錄、路由、外掛和服務,直至故障仍在你能解釋的最小 fixture 中出現。這對私隱和推理都有好處:十行的 fixture 披露的資料較少,也令模型少摻入無關路徑。
分享日誌前,刪除權杖、Cookie、簽署 URL、用戶識別碼、內部主機名稱、私人路徑和生產資料內容。證據含有個人或機密資料時,遵從 AI 私隱風險指南。
修改程式碼前,先保存故障的輸入和輸出。如果已有測試能顯示這個 bug,不要為了令測試套件變綠而削弱或刪除它。如果還沒有測試,先寫出最小的重現,即使起初只是本地腳本。
基準應回答:甚麼失敗、失敗得有多穩定、附近哪些情況目前正常?例如同時保存故障個案 a,,b 和有效對照 a,b。沒有對照,一個修補可能以拒絕所有輸入來「修好」這個 bug。
分享最小 fixture、故障指令、確切錯誤、相關函數、調用方,以及最近一次已知正常的行為。然後要求模型先覆述證據,再提出原因。
可以使用這樣的提示詞:
根據失敗的測試和解析器程式碼,按與證據的吻合程度列出最多四個假設。就每個假設,指出一項能支持它的觀察和一項能排除它的觀察。暫時不要提出修補。說明還欠缺哪些資料。
這種結構可抵抗過早下結論。如果你告訴模型「快取過期了」,即使追蹤結果指向別處,它也可能圍繞快取編出一套解釋。由發生了甚麼說起,而不是由你希望的原因說起。
一般的程式碼生成設定,請看另外的 AI 編程入門工作流程。只有當你手上有一個具體的不符之處要調查時,除錯才真正開始。
按與證據的吻合程度、測試難易和實驗風險為原因排序。唯讀的追蹤或聚焦的單元測試,通常應排在依賴升級、資料庫遷移或生產設定改動之前。
問一問:擬議的檢查能否區分至少兩個假設?「到處多加記錄」只會製造雜訊。「在計數前即時擷取 token 列表,並與預期的三個位置比較」則能直接檢驗多出的值是在解析還是計數中產生。
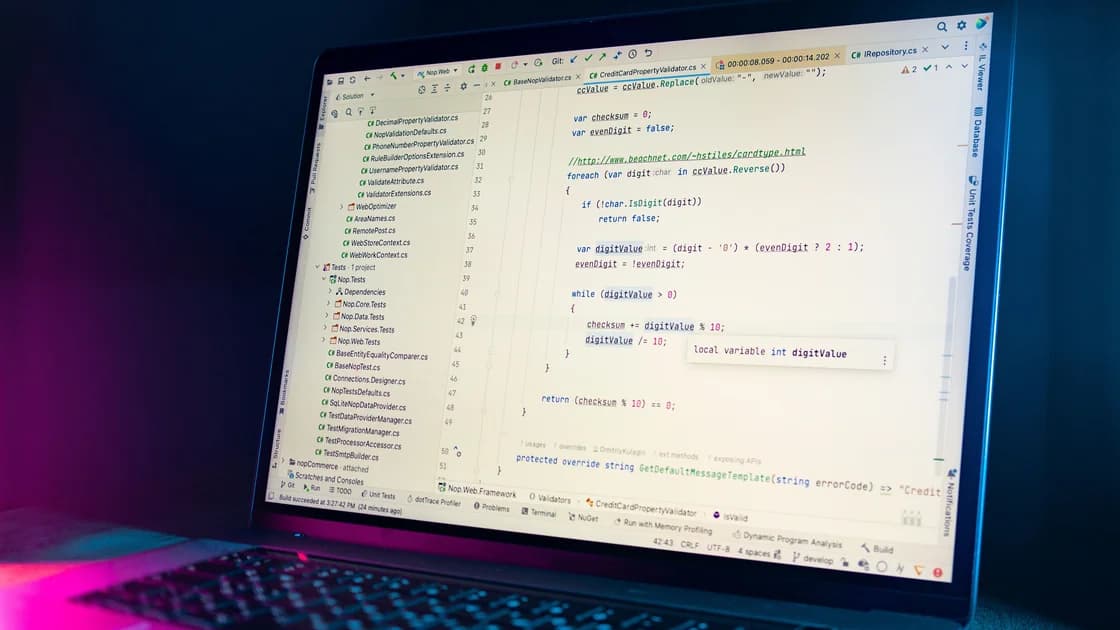
此為受控的本地擷取畫面,使用合成的解析器和測試輸出;不含生產日誌、帳戶資料或秘密,亦不代表已完成的 AI 修正。
使用現有的除錯器、追蹤開關、臨時斷言、聚焦的記錄語句或只供測試的探針。觀測方法保持在本地、可以移除。除非系統負責人另行批准該設計,否則不要為了調查一個小故障而加入永久的遙測依賴。
指令可能寫入檔案、調用服務或修改資料庫時,執行前先覆核。OpenAI 把沙盒界線、審批、網絡政策和審計記錄描述為編碼代理的不同控制措施。[2] 除錯提示詞本身無法強制執行這些控制。
只改變一個有意義的變數。執行同一條重現指令並記錄結果,包括意料之外的結果。如果同時改動了輸入、逾時、依賴和程式碼,你就無法判斷哪一項起了作用。
使用三種結果:
「未有定論」也有用。它提示你設計更好的實驗,而不是去要一個語氣更肯定的解釋。
如果模型每次失敗後都提出新假設,就要求它把新想法與證據帳簿互相印證。與已保存觀察矛盾的原因,沒有新證據就不應再出現。
只有某個原因得到支持後,才要求修補。說明根本原因、要求的行為、兼容性界線和回歸測試。要求針對原因的最小改動,而不是壓制症狀。
覆核修補是否:
執行擬議修補前,特別是涉及驗證、路徑、查詢、子程序或儲存時,使用 AI 生成程式碼審查清單。
先執行原本的故障個案,再執行有效對照、邊界情況、格式錯誤的輸入和最接近的現有測試組。回歸測試通過是必要的,但如果修補破壞了調用方或改變了錯誤契約,這仍不足夠。
以行為而非實作為回歸測試命名。rejects_empty_token_when_counting_fields 比 calls_filter_before_len 更經得起重構。這個測試應在舊行為下失敗,並因驗收準則所述的原因而通過。
NIST 的 SSDF 把覆核、分析、測試和漏洞應變視為互相關連的安全開發活動。[3] 採用這個較廣的角度:除錯過程負責找證據,程式碼覆核負責檢查改動,測試涵蓋預期行為,運作環境的驗證則另行進行。
記錄:
這份記錄可防止下一位維護者重複同樣的調查,也能揭示所謂「根因」其實仍只是一個聽來合理的故事。
不要貼上未脫敏的生產日誌,不要在重現故障前便接納修補,不要同時嘗試幾個推測性修正,也不要刪除失敗的測試。避免請模型「隨便試,直至能執行」;這種指示追求的是症狀消失,而不是理解系統。
亦不要把本地執行成功當作生產環境的證明。設定、權限、流量、作業系統行為和外部服務都可能不同。記錄這些缺口,把驗證交給正確的負責人和環境。
模型引述某個框架行為或語言規則時,使用 AI 答案事實核查方法。在它成為診斷的一部分之前,先在官方文件或以最小的可執行示例核實。
它可以提出並整理可能的原因,但「根因」的說法需要來自追蹤、實驗、測試或程式碼路徑的證據。沒有根據的解釋只能視為假設。
提供最小 fixture、確切指令、錯誤輸出、相關程式碼、調用方、預期行為,以及影響故障的環境細節。刪除秘密、個人資料和無關的生產背景。
不應該。先請模型覆述證據、為假設排序,並提出一項能區分原因的檢查。重現之前寫出的修補,可能解決的是另一個問題。
記錄頻率、時序、隨機種子、執行次序、資源狀態和嘗試次數。用 AI 除錯間歇故障時,要求它提出能預測這些規律的假設,再改變一個變數或加入聚焦的觀測。
回到證據帳簿。否決與已記錄觀察矛盾的假設;如果新的迭代不再帶來能區分原因的證據,就停下來。
只有在機構容許使用該服務和該資料時才可以。把日誌減到最少,刪除憑證和識別碼,並盡可能改用合成的重現。
它證明的是該環境中被涵蓋的那個個案。還要執行附近的測試、覆核 diff,並記錄仍屬其他階段的平台、整合或生產檢查。
免責聲明:本文只提供一般技術資訊。真實系統應遵守機構的事故、私隱、安全及變更控制流程。
來源:
Sources checked 2026 年 8 月 24 日。
延伸閱讀:
註冊即可免費體驗全部高級功能。
*只限新用戶;每位用戶只可獲得一次試用。