開啟 3 天免費試用
註冊即可免費體驗全部高級功能。
*只限新用戶;每位用戶只可獲得一次試用。
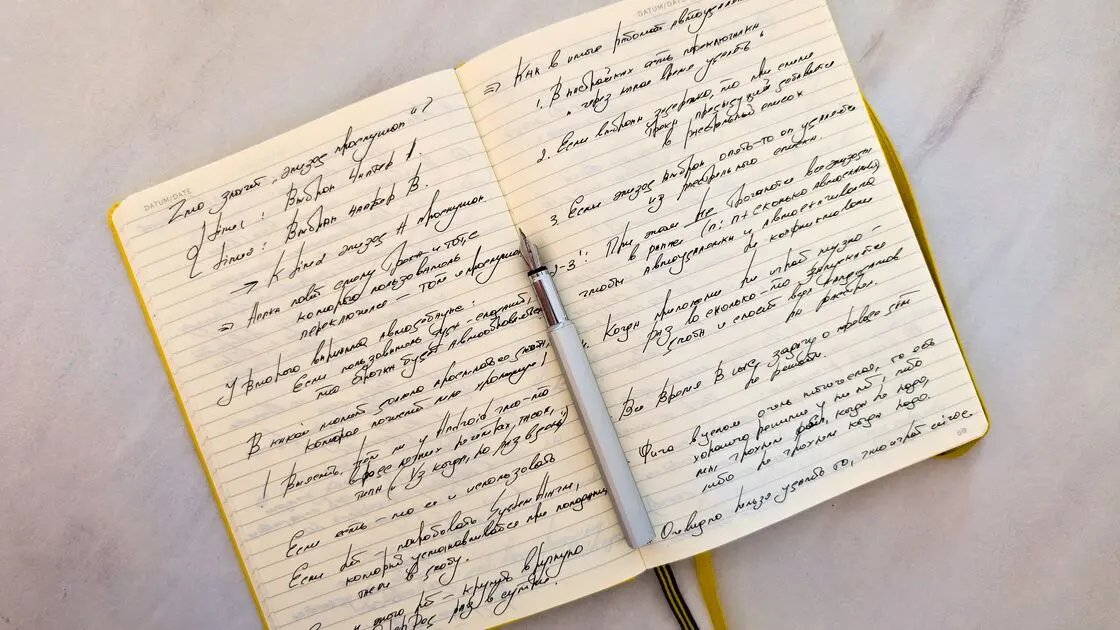

要用 AI 將手寫筆記轉成可編輯文字,先保留原始頁面,拍攝清晰,再逐頁執行手寫 OCR,並對照影像覆核每個不確定的字元。把忠實轉錄與任何編輯版本分開,以免文法潤飾變成對「作者在紙上寫了甚麼」的錯誤陳述。
關鍵要點:
- 清晰的原圖能改善 OCR,但不會令結果變得權威。
- 潤飾之前,先保留頁序、換行、剔選框、邊註和不確定之處。
- 人名、數字、日期、單位和短標籤要逐字元核對。
- 原始影像、原始 OCR、覆核後的轉錄稿和編輯記錄分層匯出。
本流程沿用安全使用 AI 的核驗閉環的原則:來源始終是權威,模型只產生供人檢查的候選結果。
先確認你有權處理這些筆記。個人筆記簿、學生功課、研究記錄、會議記錄、客戶筆記,以及醫療或法律材料,可能各有不同的保密、保留和同意責任。不要把含有密碼、存取密鑰、身份證明文件、私人客戶資料或其他不必要敏感資料的頁面,上載到未獲批准的服務。
編輯任何內容之前,先凍結原件。為每頁設定固定識別碼,例如 Notebook-03 / Page-017,記錄拍攝日期,並保持原始檔案不變。如果頁面有正反兩面,兩面都要清楚編號。一整個資料夾按相機時間命名的匿名相片,很容易被意外打亂次序。
手寫 OCR 是文件辨識任務,而不是創意寫作。Google Cloud Vision 的文件說明,DOCUMENT_TEXT_DETECTION 是針對密集文字和文件(包括手寫)優化的 OCR 模式,其回應可保留頁、區塊、段落、字詞和符號結構。[1] Microsoft Document Intelligence Read v4.0 可以從掃描影像和文件中提取印刷及手寫文字,並傳回字詞、行、位置和可信度數值。[2] 兩者都不能免除對照原件核對輸出的需要。
處理前先使用一份簡單的登記表:
| 頁面 ID | 原始檔案 | 正反面 | 語言 | 書寫者 | 敏感程度 | 拍攝質素 | 覆核者 |
|---|---|---|---|---|---|---|---|
| N03-P017 | IMG_4812.jpg | 正面 | 英文 | 已知 | 內部 | 良好 | OP |
| N03-P018 | IMG_4813.jpg | 背面 | 英文 | 已知 | 內部 | 邊緣有陰影 | OP |
如果不知道書寫者、語言或頁序,就記為 unknown。清楚寫明「未知」,比日後嵌入文字中的看似合理的猜測更安全。
拍攝質素決定辨識器能看到多少證據。使用均勻光線,相機與紙面平行,拍齊四角,對焦在墨跡而不是底下的桌面。避免手指遮擋文字、強烈陰影、反光、過度濾鏡,以及會裁走邊註的透視校正。
美國國家檔案及記錄管理局的數碼化指引強調,要透過受控的拍攝、質素覆核和保存考量製作生產母版檔案。[3] 你的筆記項目也許規模小得多,但這個區分同樣有用:保留一份高質素母版,工作副本都由母版衍生。
每一頁:
不要把一張細小又模糊的相片放大後就稱為「修復」。放大或令影像看來更平滑,底下的字元卻依然含糊。原圖不足時,把該頁標為需要重拍。
旋轉、無損的方向校正,以及只裁去頁面以外範圍的保守裁剪,可令影像更易處理。修改筆畫、擦掉刪劃、把對比度調到淡痕跡消失,或補回缺角,都會改變證據。保留母版,並記錄每一步衍生操作。
逐頁或按次序以小批次處理。大批混雜的頁面,更難察覺缺頁、正反面顛倒或語言轉換。工具提供模式選擇時,選文件 OCR 或手寫辨識;一般的影像描述模型可能會轉述頁面,而不是轉錄。
使用受來源約束的指示:
忠實轉錄手寫內容。在可見的情況下,保留頁面 ID、標題、換行、列表符號、剔選框、刪除內容、箭嘴和邊註。無法辨認的字元寫
[unclear],並附上前後文字。不要更正拼字、補全殘句、推斷人名,也不要把筆記改寫成報告。
要求按頁輸出並附行標識。版面重要時,要求標出區域,例如 top-left、main body 和 right margin。輸出應分辨已剔選和未剔選的方框,以及被刪劃的片語和已確認的片語。
Microsoft 現行的 Document Intelligence Read 模型會傳回辨識出的字詞和行,並附邊界多邊形和可信度數值。[2] 位置資料很有用,能讓覆核人回到確切的區域。可信度可協助排定覆核優先次序,但高分並不能證明一個簡短的人名或數字正確。
| 頁碼或區域 | 原始 OCR | 編輯文字 | 可信度 | 修改理由 | 覆核者 |
|---|---|---|---|---|---|
| N03-P017 第 4 行 | send to Marla 8/7 | send to Maria 8/7 | 低 | 已對照手寫核對人名 | OP |
| N03-P017 邊註 | [unclear] 15 | [unclear] 15 | 未解決 | 首字被遮擋 | 待定 |
| N03-P018 方框 2 | [x] call vendor | [x] call vendor | 高 | 已確認剔選框和文字 | OP |
這個表格形成一條編輯記錄,也可防止覆核人在沒有記錄依據下「修正」句子——改動究竟來自頁面、外部知識還是文風偏好。
分兩輪覆核。第一輪逐頁檢查轉錄是否忠實;第二輪檢查合併後的文件是否連貫,有沒有缺頁、重複文字或不一致的寫法。
短字串幾乎沒有上下文,一個字元就可能改變含義。放大原圖逐一核對:
逐個閱讀數字,不要因格式眼熟就接受。1、7、9、0 和 6 可能難以分辨;小數分隔符和日期次序視乎地區習慣。來源沒有確定格式時,不要把 08/09 悄悄統一成某個日期。
使用一致的標記,例如 [unclear]、[illegible: 2–3 chars] 或 [possible: Chen/Chin],並附上頁碼和區域。絕不要讓模型揀一個最合理的字詞,再刪去不確定標記。
NIST 的生成式 AI 風險概況把虛構、私隱、資訊完整性和人工監督列為風險範疇。[4] 在本流程中,不確定標記和人工覆核隊列就是應對這些風險的具體控制。
把頁面登記表與輸出對照。確認每頁剛好出現一次,正反面次序正確,標題仍與其內容相連,續寫標記沒有被誤當作新章節。留意因相片重疊而重複出現的首行或末行。
如果書寫者用了箭嘴或空間分組,描述關係時不要過度詮釋:寫「由項目 A 指向項目 B 的箭嘴」,而不是「項目 A 導致項目 B」。空間含義對白板尤其重要,白板需要另一套理解版面的流程。
把覆核後的轉錄稿設為唯讀,再另建一份編輯稿。編輯稿只可在明確規則下規範空格、展開縮寫、更正拼字或重組標題,不得覆寫忠實層。
使用三層結構:
標示所有加入的內容。如為方便瀏覽加入標題,寫 [editor heading]。如果借助其他來源的背景確認了某個人名,記錄外部證據,而不是假裝手寫本來就清楚。如果要把筆記變成正式交付成果,在轉錄獲批後使用獨立的筆記轉報告流程。
選擇開放、可編輯的格式,例如純文字、Markdown、用於結構化欄位的 CSV,或文書處理文件。寫明項目名稱、頁碼範圍、OCR 工具和模式、處理日期、覆核人、未解決數目和編輯政策。
原始 OCR 只在有助審計改動時才作為中間產物保留,不可被誤當作覆核後的轉錄稿。所有副本——包括雲端上載和臨時匯出——都要遵守機構的保留和存取規定。
模型可能把殘句補成完整句子。先要求忠實轉錄,再在副本中按清晰可見的規則編輯。
可信度是排序覆核的訊號,不是事實依據。高可信度的人名、日期和數字仍須直接覆核。
純文字可能抹去狀態。清楚表示未剔選框、已剔選框、刪除、插入和邊註。
原圖能解決爭議,也能支援日後改進。保留固定的母版,絕不要以增強後的衍生圖取代。
缺頁或重複頁可能藏在一份潤飾過的文件內。合併文字前,先核對頁面登記表。
它能提供有用的初稿,但準確度因字跡、語言、影像質素、版面和上下文而異。把每份輸出都視為候選轉錄,並對照頁面核對有後果的欄位。
兩者皆可。掃描器的幾何和光線較一致;手機則很方便,前提是與紙面平行、對焦清晰、光線均勻,並拍齊所有邊緣。
保留不確定標記,並附頁碼和區域。重拍該頁、比對附近的字跡樣本,或請獲授權的覆核人判斷;不要以最合理的字詞填補空白。
忠實層內不可以。先保留原本寫下的內容,再另建一份編輯稿,並記錄其拼字和文法規則。
清楚表示其可見狀態和位置。描述關係時保持審慎,不要把旁邊的筆記或箭嘴變成已批准的行動或因果結論。
不可以。以 OCR 可信度排定覆核次序,但即使可信度很高,也要檢查人名、編碼、日期、數字和單位。
不可以。先確認服務、帳戶、保留、存取權限和機構批准,並刪除不必要的敏感資料。部分材料應留在獲批的本地或企業環境。
按保留政策保存未經改動的原始影像、覆核後的轉錄稿、編輯稿、頁面登記表、修改記錄和未解決事項清單。
來源:
Sources checked 2026 年 8 月 30 日。
延伸閱讀:
註冊即可免費體驗全部高級功能。
*只限新用戶;每位用戶只可獲得一次試用。